目次
結果から書くと、公式成績は26位・5,701点だった。個人参加で、AIの利用も認められていた。
今回試したかったのは、「LLM一つでCTFの問題をどこまで解けるか」だけではない。問題を取り込み、複数のagentに振り分け、添付ファイルを扱い、答えの候補を検証し、提出まで一つのpipelineとして動かしたときに、実際はどこで詰まるのかを見たかった。
やってみると、問題を解く部分は思っていたより進んだ。むしろ難しかったのは、複数のworkerが同時に動く中で、誰がどの問題を担当しているのか、どのstateを正とするのか、どのファイルがどのchallengeに属するのか、そしていつ提出を止めるのかを揃え続けることだった。
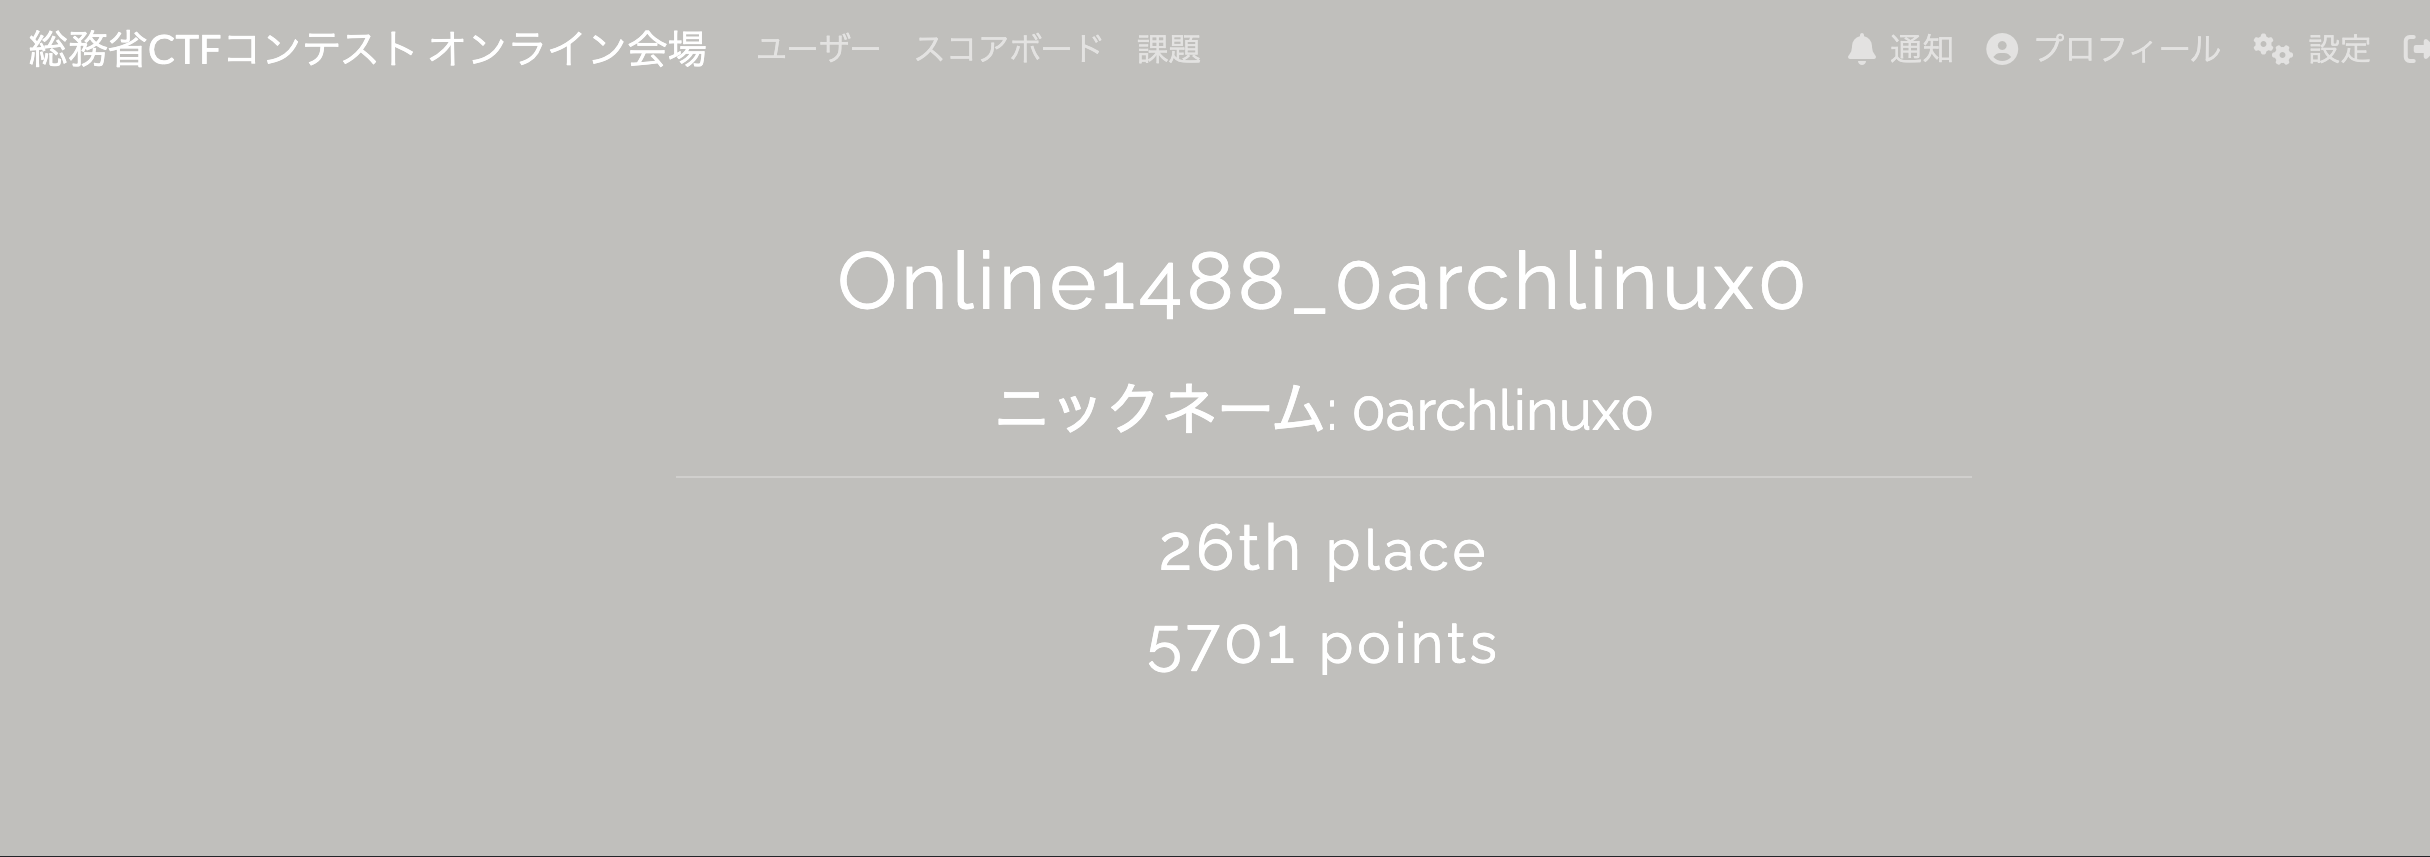
公式CTF成績: 26位 · 5,701点
参加形態 / 規則: 個人参加 · AI利用可
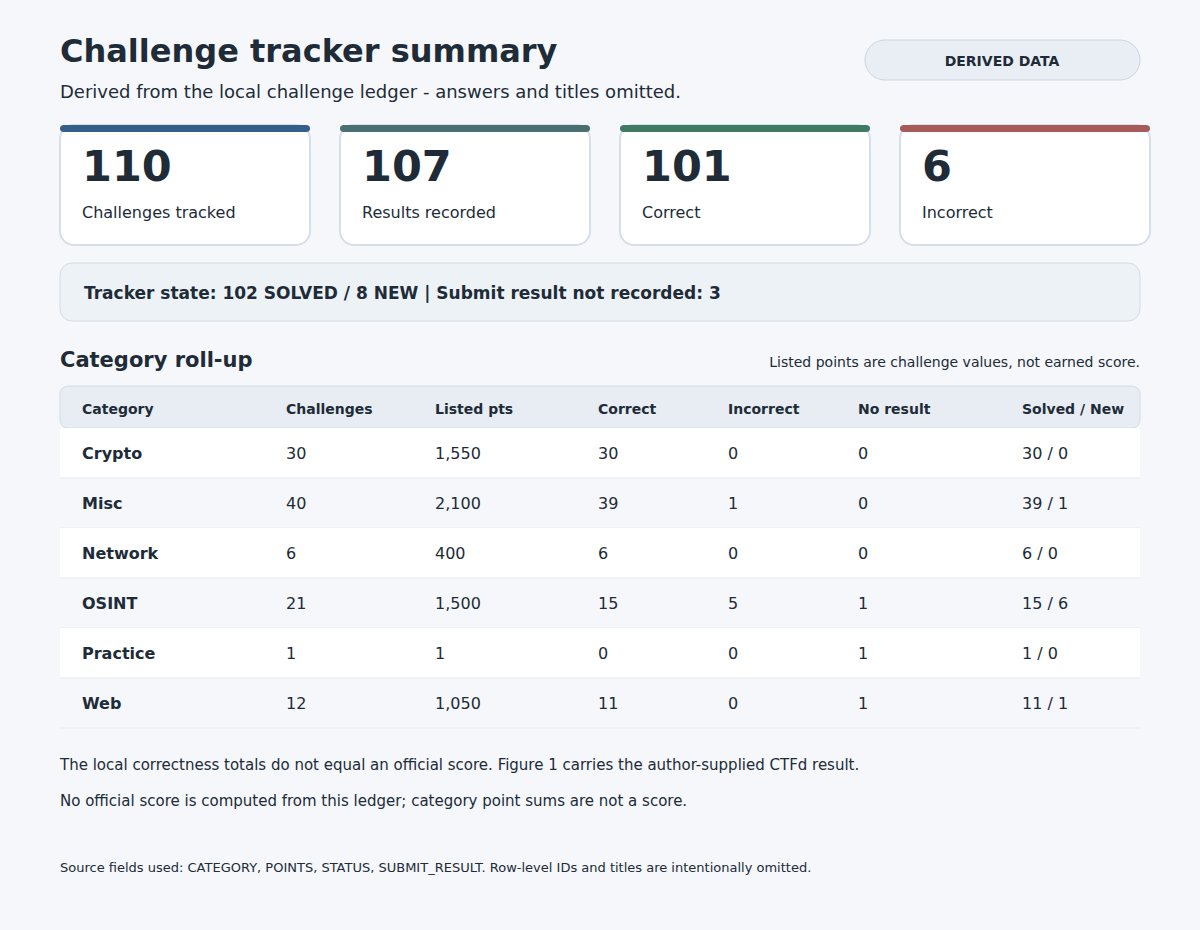
手元のtracker: 追跡対象110問 · 提出結果107件 · local correct 101件 · incorrect 6件 · 結果記録なし3件
今回試したかったこと
互いにある程度独立した問題が並ぶCTFは、multi-agentの実験には向いているように見える。問題を集め、必要なファイルを取り込み、workerに割り当て、答えの候補を作り、検証して提出する。
文章にすると単純だが、実際にはその矢印の間すべてにshared stateが必要だった。
今回見たかったのはまさにそこだ。なので、これは個別challengeの解法記事ではなく、pipelineを実際に運用した振り返りである。公式成績と手元のtrackerは分け、残っている記録が言える範囲だけで当時の動きを見直す。
結果
手元のtrackerには110問が残っている。そのうち107問には提出結果があり、localでは101件がcorrect、6件がincorrectと記録されていた。残る3件には結果の記録がない。
この107という数字を「自動で解いた問題数」と読むことはできない。あくまで提出結果がtrackerに残っている行数だ。
correctと記録された101件のnominal pointを足すと5,900点になる。一方、公式成績は5,701点だった。199点の差がなぜ生じたのかは、今残っている資料だけでは説明できない。無理に一つの数字に合わせず、別の記録として扱うことにした。
どう回したか
ローカルの記録には110問すべてが残り、20個のchallenge IDに合計21個のattachmentがひもづいている。セッションログにはlocal advisor/modelとremote APIの両方が出てくる。複数の問題を並列に処理する指示もあり、提出だけを担当する別のsubmission workerも使っていた。
つまり、大きな流れはかなり分かる。複数のworkerが並列に解き、提出は別の経路に集約していた。
一方で、問題単位の細かなtraceは十分に残せていない。どのchallengeをどのworker/modelに割り当てたのか、私がどの時点で介入したのか、何回retryしたのかまで、提出結果と一続きになった記録はない。結果はかなり残っているが、そこに至る経路はところどころ抜けている。
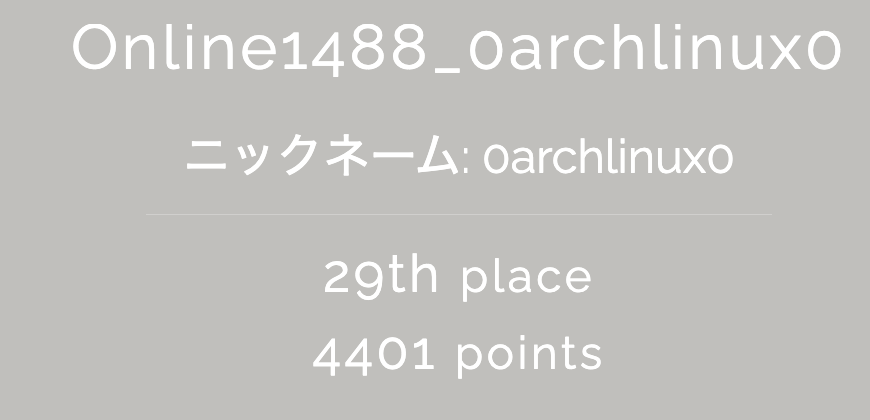
大会中のスクリーンショットの一つには、29位・4,401点の時点が残っている。元の画像にはOMP画面とchallengeごとの履歴も写っていたが、公開版ではCTFプロフィール部分だけを切り出した。さらに早い約13:53 JSTの画面は302位・1点だった。Figure 1の最終結果とは別の、序盤の状態だ。
残っているcontrol-plane eventと人の介入記録を時間順に並べ、補助的なtimelineも再構成した。
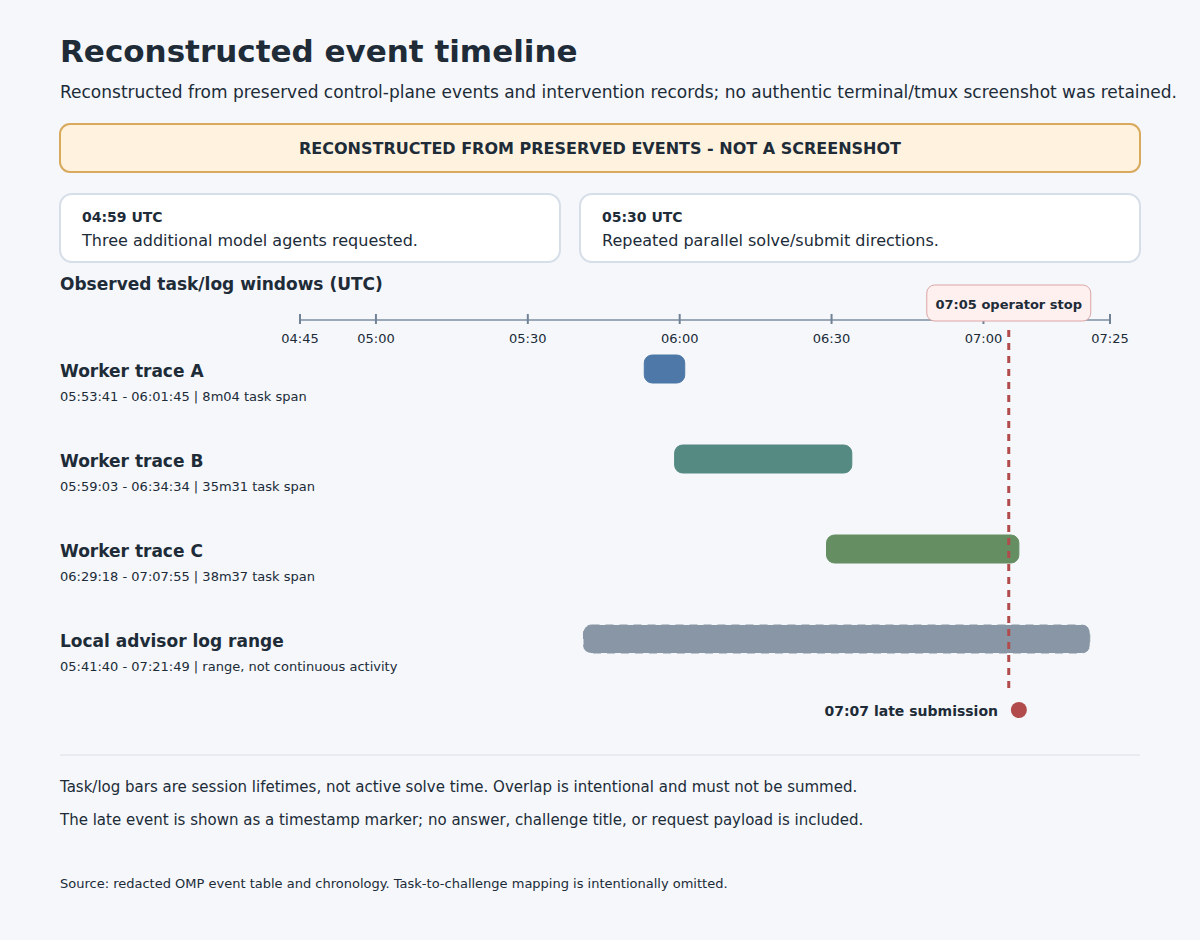
この図で分かるのは、いつ何が重なって動いていたかという流れまでだ。各バーの長さを実際の問題解決時間として使えるほどのper-challenge tracingは、当時のシステムにはなかった。
難しかったのは、解くことより状態を知ること
trackerを見れば、最終的にどの問題が解けたか、どんな提出結果が残ったかはある程度分かる。ところが大会中に本当に知りたかったのは別のことだった。
今この問題を誰が持っているのか。別のworkerがすでに同じ問題を解いていないか。提出結果はqueueに反映されたか。このtaskはまだ走り続けるべきなのか。
こうした質問にすぐ答えるのが難しかった。
HTTP requestが成功したことと、CTF側が答えをcorrectと判定したことも別だ。workerごとに少しずつ違うqueue stateを見ていたり、submission resultの反映が遅れたりすれば、同じ問題に重複して取り組みやすい。締切直前なら、すでに意味を失ったtaskがそのまま走り続けることもありうる。
残ったログだけから、実際の重複作業が何件あったのかまで数えることはできない。それでも、そうした問題が起きやすい構造だったことは十分に分かった。
ボトルネックはmodelよりcontrol planeだった
始める前は、当然modelの性能が一番大きな変数になると思っていた。実際に回してみると、複数のagentを一つのsystemとして動かすほうが難しかった。
- Ownership / state: challengeごとにauthoritative ownerと期限付きleaseが必要だ。これがないと重複作業を防ぐのも、あとから測るのも難しい。
- Artifact intake: challenge ID、file hash、type、provenanceを一緒に残し、controllerが認識しているファイルとsolverが実際に受け取ったファイルが一致しているか確認できるようにする。
- Verification: candidate answerは提出前に形式と意味を別の段階で確認する。
- Observability: ingest → assign → solve → verify → submit → accepted/rejectedをchallenge IDで一本につなぐ。そうしないとmodelが遅いのか、queue/control planeで待っているのかを分離できない。
- Close control: 公式終了時刻で新規作業を止め、進行中taskを整理し、最終結果を取得してlocal trackerと照合する。
派手なmodel improvementではなく、典型的なdistributed systemsの問題が最後まで残った。workerが増えるほど、この層の重要性はむしろ上がる。
ローカルモデルとAPI
今回、local modelとremote APIの両方を使っていたこと自体は記録から確認できる。ただし、challengeごとにどのrouteを選んだかは十分に残していない。
そのため、「local computeでAPI callを何回減らせた」「人が何問を救った」といった数字を後付けで作ることはしない。次回はroute decisionそのものをeventとして残したい。答えだけでなく、どの実行経路がその答えを作り、なぜそのrouteを選んだのかまで記録して初めて比較できる。
次はこう変える
次のversionは、challenge IDをkeyにしたcanonical queueを一つ置くところから始める。
workerはstateを自分の側にコピーして持つのではなく、leaseを取得してchallengeを担当する。intakeではfile type、hash、provenanceを記録する。まずdeterministicなlocal analysisを試し、必要な場合だけhealth check済みのlocal modelか、明示的なbudgetを持つremote APIへ回す。
答えの候補はprivate evidence storeに集約し、independent verifierを通ったものだけを一つのsubmission brokerから送る。公式cutoffに達したらbrokerを閉じ、進行中のtaskをdrain/cancelして、最終CTF結果とlocal trackerを照合する。
- 01challenge IDをキーにするcanonical queuechallengeごとのactive lease
- 02検証済みartifactの取り込みfile type・hash・provenanceを記録
- 03決定的なlocal analysis提案する処理の最初の段階
- 04health check済みmodelへのroutinglocal model、またはbudgetを明示したremote API
- 05private evidenceと独立した検証提出前に候補を確認
- 06単一のsubmission brokerとcutoffスコア照合の前に提出を止める
下の比較図では、残っている記録と次回の設計案を分けて示す。
V1 — 記録から確認できる範囲
証拠は不完全で、end-to-endのpipelineが検証されたわけではない。
- challenge snapshotchallenge snapshot 110件
- local attachment20個のIDにまたがる21ファイル。対応関係は確認できない
- status tracker110行、提出結果107件
- 記録された結果correct 101件、incorrect 6件
- ingestと割り当て方法、challengeごとのowner、solverとの対応
- 提出の自動化とretry、route telemetry、cutoff後の照合
traceからOMP/modelの並行稼働は確認できるが、challenge単位の割り当てとroute対応は確認できない。
V2 — 次の設計案
大会時の実装を説明するものではなく、次回に向けた設計案である。
- 01challenge sourcepromptとartifactへの参照
- 02ingest + artifact integrityhash・type・変更できないpacketを記録
- 03canonical challenge queue + keyed owner leasechallengeごとにownerを一人にし、state transitionを追記のみで記録
- 04risk-tiered solver routing
- Local fast
- Local strong
- API escalation
- 05candidate + evidenceprivateに保管し、payloadはvaultに置く
- 06independent verifierevidenceと形式を確認するgate
- 07submission brokerrequestを一つにまとめ、cutoffで停止
- 08CTFd response + reconciliationHTTP statusは正誤の判定とは異なる
- 追記専用のevent ledger
- challengeごとのowner lease
- 人の介入記録
- route/token/cost telemetry
- 全体cutoff / close barrier
- 公式結果との照合
右側の項目はすべて提案であり、大会時の記録から確認された事実ではない。
振り返って
今回の結論は、「agentを増やせばそのまま多く解ける」というものではなかった。
個々のworkerがある程度仕事をこなせるようになると、ボトルネックは上の層へ移る。ownership、state、verification、observability、shutdownが曖昧なままworkerだけを増やすと、速くなるどころかsystem全体が見えにくくなることもある。
もう一度やるなら、まず「今このchallengeを誰が持ち、どのstateを通り、なぜこの結果になったのか」を一本のtraceで追えるようにする。そのあとでparallelismを増やしたほうがいい。
記録と範囲
- Figure 1は公式最終結果の26位・5,701点を示す。
- local trackerには110問と107件の提出結果(correct 101、incorrect 6、結果記録なし3)が残っている。correct行のnominal point合計は5,900点で、公式5,701点との差199点は説明できていない。
- Figure 4は大会中の29位・4,401点時点を切り出した公開crop。元画像のOMP画面とchallenge別履歴は公開していない。約13:53 JSTの302位・1点はさらに早い状態だった。
- 補助timelineとFigure 5のV1は残っている記録からの再構成で、V2は提案である。
- challengeごとのmodel routeと人の介入回数は不完全なため、正確な自動化率は示していない。