이 글의 목차
결과부터 쓰면 공식 26위, 5,701점이었다. 개인 참가였고 AI 사용도 허용됐다.
이번에 시험해보고 싶었던 건 “LLM 하나가 CTF 문제를 얼마나 잘 푸느냐”가 아니었다. 문제를 가져와 여러 agent에게 나눠 맡기고, attachment를 모으고, 답 후보를 검증하고, 제출까지 한 pipeline으로 묶었을 때 실제로 어디서 깨지는지가 더 궁금했다.
결론부터 말하면 문제 풀이 자체는 생각보다 잘 됐다. 더 어려웠던 건 여러 worker가 동시에 움직이는 동안 누가 어떤 문제를 맡고 있는지, 어떤 상태를 믿어야 하는지, 어느 파일이 어느 challenge에 속하는지, 제출을 언제 멈춰야 하는지를 계속 맞추는 일이었다.
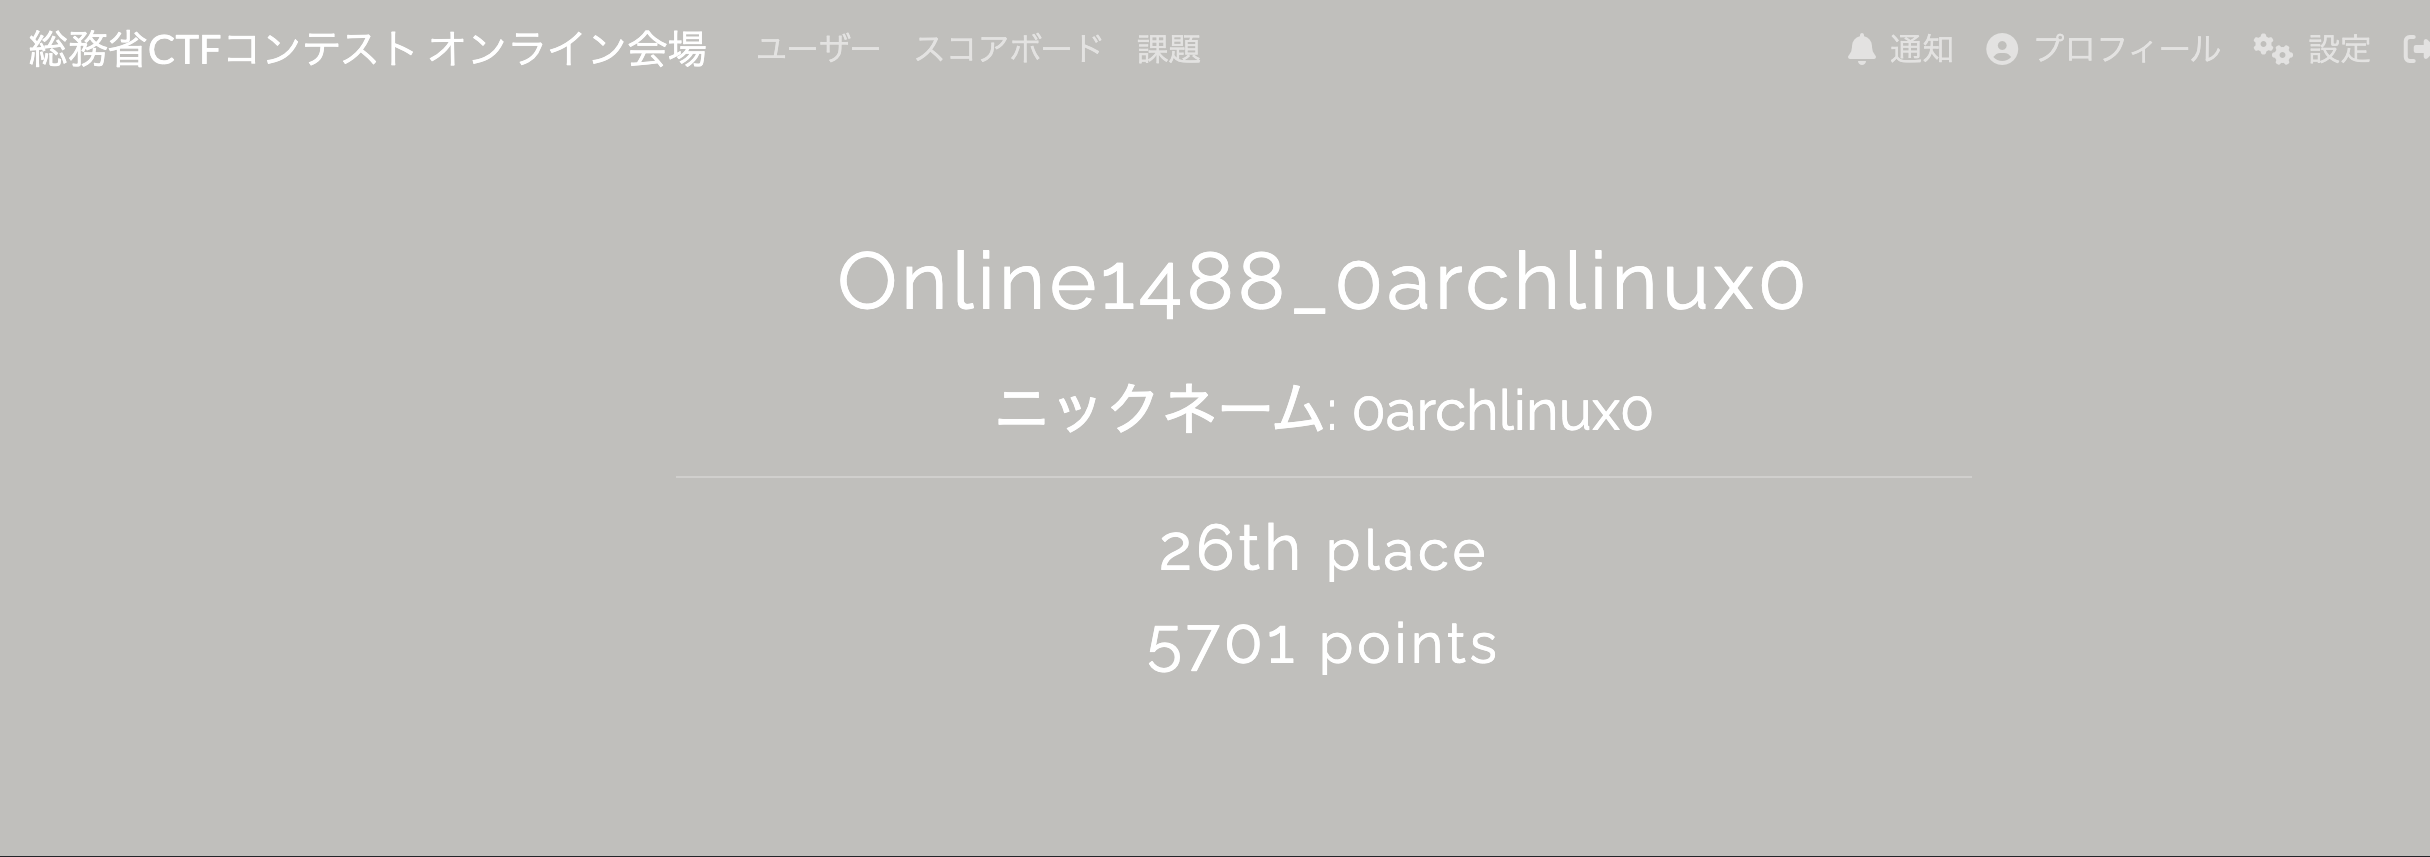
공식 CTF 결과: 26위 · 5,701점
참가 형태 / 규정: 개인 참가 · AI 사용 허용
local tracker: 기록된 문제 110개 · 제출 결과 107건 · local correct 101건 · incorrect 6건 · 결과 미기록 3건
이번에 보고 싶었던 것
문제가 서로 어느 정도 독립적인 CTF는 multi-agent 실험에 꽤 잘 맞아 보인다. 문제를 수집하고, 파일을 받아서, worker에게 할당하고, 답 후보를 만들고, 검증해서 제출하면 된다.
말로 쓰면 단순하다. 실제로는 저 화살표 사이마다 shared state가 필요했다.
이번 실험에서 보고 싶었던 것도 그 부분이었다. 그래서 이 글은 challenge 풀이 write-up이 아니라 운영 회고다. 공식 결과와 local tracker는 따로 두고, 남아 있는 기록이 말해주는 범위 안에서만 당시 pipeline을 다시 본다.
결과
local tracker에는 110개의 challenge가 남아 있다. 이 중 107개에는 제출 결과가 기록돼 있었고, local 기준으로 correct 101건, incorrect 6건이었다. 나머지 3건은 결과가 없다.
여기서 107이라는 숫자를 “자동으로 푼 문제 수”로 읽으면 안 된다. 그냥 tracker에 제출 결과가 남아 있는 행의 수다.
correct로 기록된 101개의 nominal point를 합치면 5,900점이 나온다. 공식 점수는 5,701점이다. 199점 차이가 왜 생겼는지는 지금 남은 기록만으로 설명할 수 없어서, 억지로 맞추지 않고 서로 다른 기록으로 남겨두기로 했다.
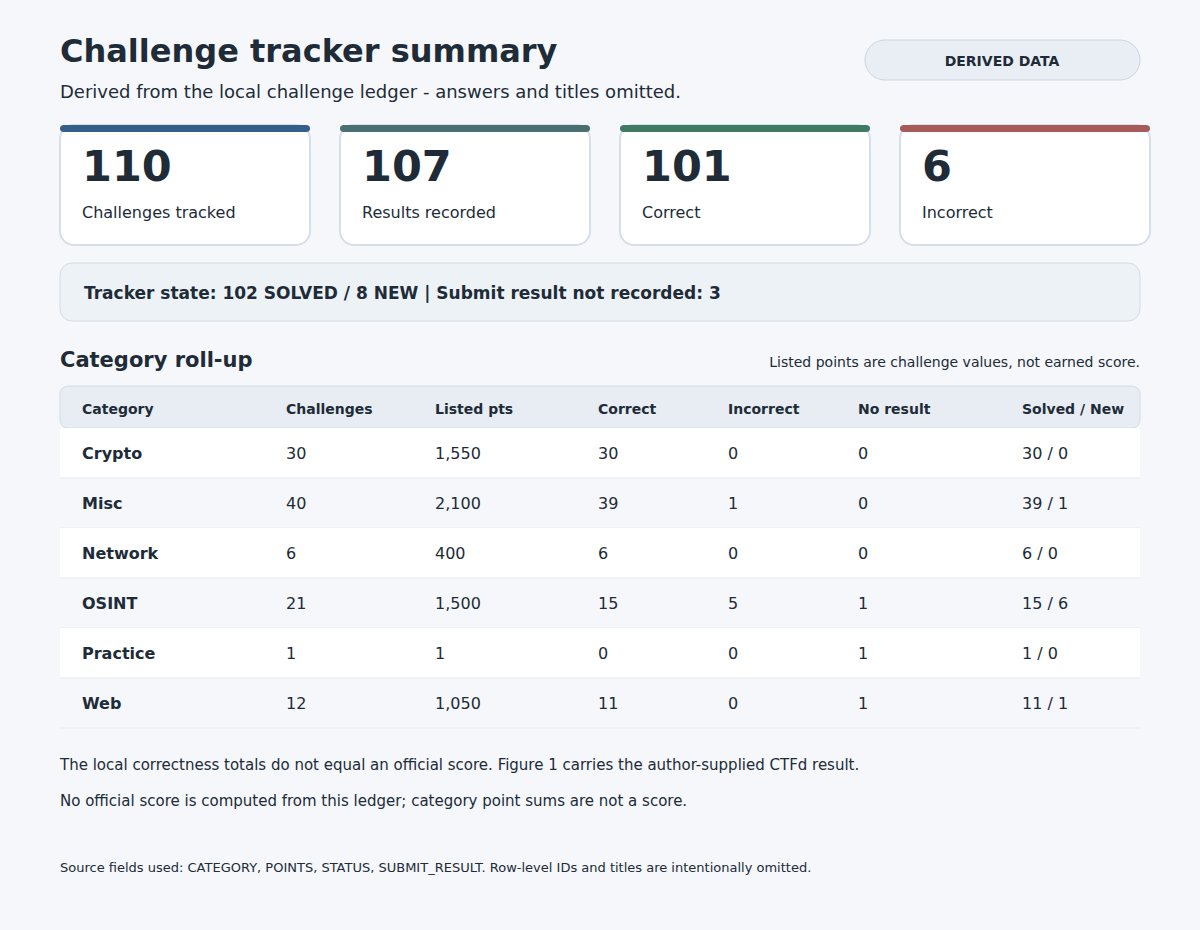
어떻게 돌렸나
로컬 기록에는 challenge 110개가 모두 남아 있고, 20개 challenge ID에 attachment 21개가 연결돼 있다. 세션 로그를 보면 local advisor/model과 remote API를 둘 다 썼다. 여러 문제를 병렬로 나눠 처리하라는 지시도 있고, 제출만 맡는 별도 submission worker의 기록도 있다.
그러니까 큰 흐름은 꽤 분명하다. 여러 worker가 병렬로 풀이를 진행하고, 제출은 별도 경로로 모았다.
반대로 문제 단위의 세부 trace는 충분히 남기지 못했다. 어느 challenge를 어느 worker/model이 맡았는지, 내가 정확히 언제 개입했는지, 몇 번 retry했는지까지 제출 결과와 이어지는 형태로 기록돼 있지는 않다. 결과는 꽤 많이 남았는데, 그 결과가 만들어진 경로는 듬성듬성하다.
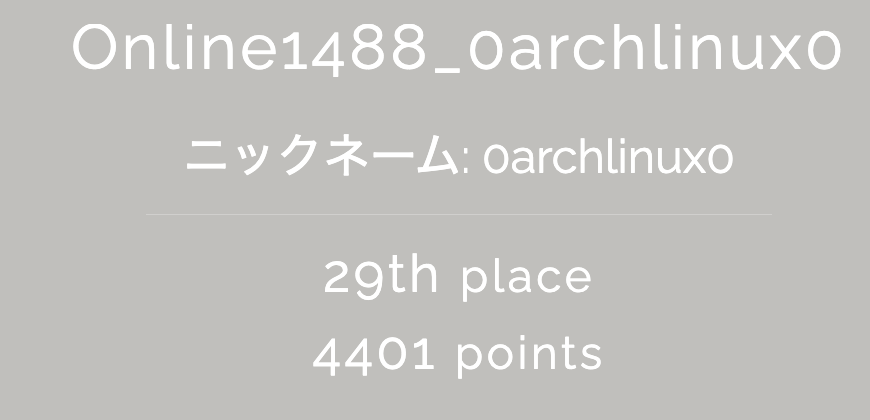
대회 도중 남긴 화면 중 하나에는 29위·4,401점이 찍혀 있다. 원본에는 OMP 화면과 challenge별 이력도 같이 있었지만 공개본에서는 CTF 프로필 부분만 잘라냈다. 더 이른 약 13:53 JST의 캡처에는 302위·1점이 보인다. 그냥 초반 상태일 뿐 Figure 1의 최종 결과와는 다른 시점이다.
남아 있는 control-plane event와 사람의 개입 기록을 시간순으로 이어서 보조 timeline도 만들었다.
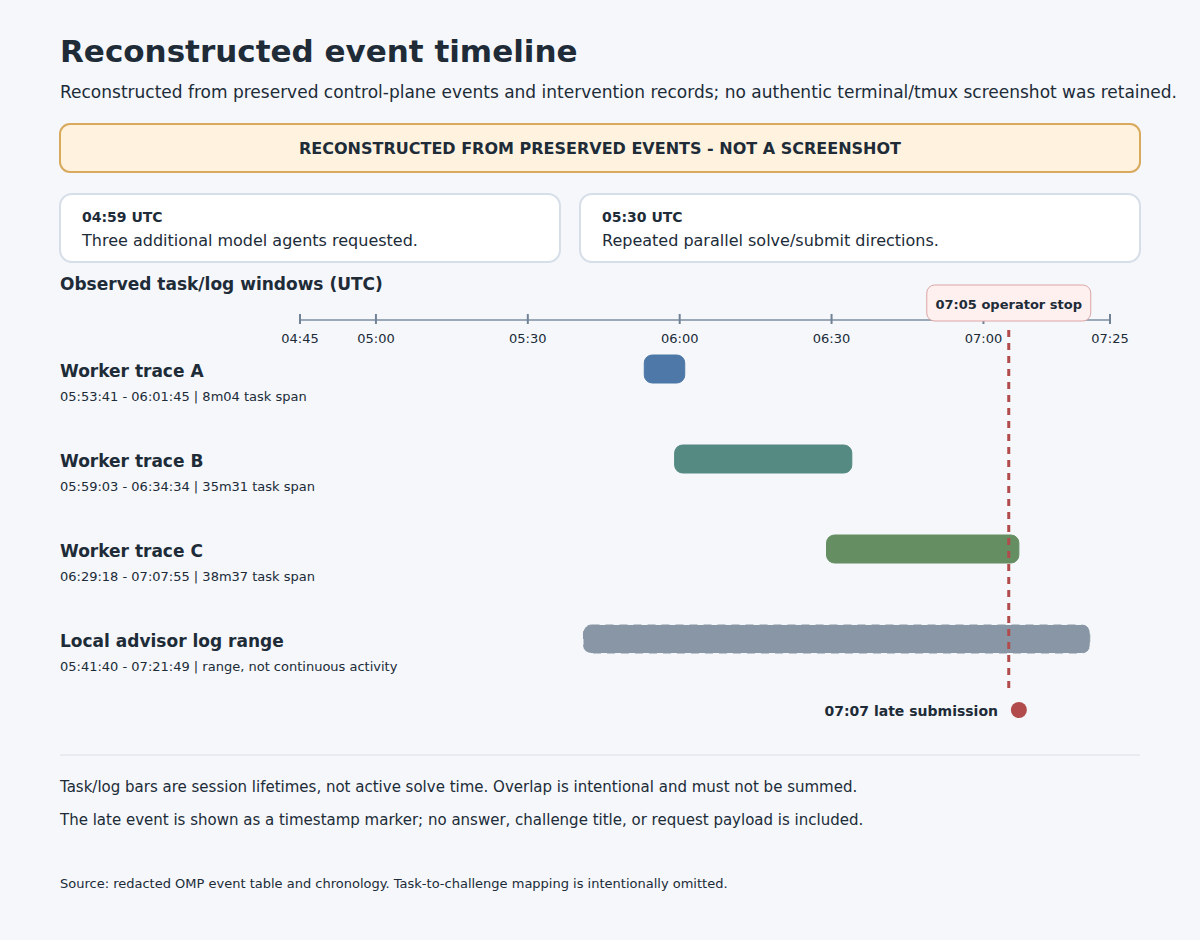
이 그림은 “언제 무엇이 겹쳐 돌아갔는가”를 보는 용도다. 각 막대 길이를 실제 solve time으로 읽을 수는 없다. 애초에 당시 시스템에 그 정도의 per-challenge tracing이 없었다.
문제는 푸는 것보다 상태를 아는 것이었다
tracker를 보면 어떤 문제가 결국 풀렸는지, 어떤 제출 결과가 남았는지는 어느 정도 알 수 있다. 그런데 대회 중에 더 필요했던 질문은 따로 있었다.
지금 누가 이 문제를 잡고 있는가? 다른 worker가 이미 같은 문제를 풀고 있지는 않은가? 제출 결과가 queue에 반영됐는가? 이 task는 아직 계속 돌아야 하는가?
이 질문에 바로 답하기가 어려웠다.
HTTP 요청이 성공했다는 것과 CTF가 답을 정답으로 판정했다는 것도 다른 일이다. worker들이 서로 다른 시점의 queue state를 보고 있거나 submission 결과가 늦게 반영되면, 같은 문제를 중복으로 풀기 쉽다. 종료 직전에는 이미 의미가 없어진 task가 계속 도는 상황도 생길 수 있다.
남은 로그만 가지고 실제 중복 작업이 몇 건이었는지 숫자를 붙일 수는 없다. 그래도 이런 문제가 생기기 쉬운 구조였다는 건 충분히 보였다.
병목은 model보다 control plane이었다
처음에는 당연히 model 성능이 가장 큰 변수가 될 거라고 생각했다. 실제로 돌려보니 여러 agent를 하나의 시스템처럼 움직이게 만드는 쪽이 더 까다로웠다.
- Ownership / state: challenge마다 authoritative owner와 만료되는 lease가 필요하다. 이게 없으면 중복 작업을 막기도, 나중에 측정하기도 어렵다.
- Artifact intake: challenge ID, file hash, type, provenance를 같이 남겨야 controller가 생각하는 파일과 solver가 실제로 받은 파일이 같은지 확인할 수 있다.
- Verification: candidate answer는 제출 전에 형식과 의미를 별도 단계에서 확인해야 한다.
- Observability: ingest → assign → solve → verify → submit → accepted/rejected를 challenge ID 하나로 이어서 볼 수 있어야 한다. 그래야 model이 느린 건지 queue/control plane에서 기다린 건지 분리할 수 있다.
- Close control: 공식 종료 시각이 오면 새 작업을 막고, 진행 중인 task를 정리하고, 최종 결과를 받아 local tracker와 대조하는 절차가 필요하다.
결국 화려한 model 개선보다 전형적인 distributed systems 문제들이 더 크게 남았다. worker 수가 늘어날수록 이 부분은 더 중요해졌다.
로컬 모델과 API
이번 run에서 local model과 remote API를 둘 다 쓴 건 확실하다. 다만 challenge마다 어떤 route를 탔는지는 제대로 남기지 못했다.
그래서 “local compute가 API 호출을 몇 번 줄였다”거나 “몇 문제는 사람이 직접 살렸다” 같은 숫자를 지금 와서 만들 생각은 없다. 대신 다음에는 route decision 자체를 event로 남길 생각이다. 답만 기록하는 게 아니라 어떤 실행 경로가 그 답을 만들었고, 왜 그 route가 선택됐는지까지 남겨야 비교가 가능하다.
다음에는 이렇게 바꾼다
다음 버전의 시작점은 challenge ID를 key로 쓰는 canonical queue 하나다.
worker는 state를 자기 쪽으로 복사해 들고 가는 대신 lease를 잡고 문제를 맡는다. intake 단계에서 file type, hash, provenance를 기록한다. 먼저 deterministic local analysis를 돌리고, 필요한 경우에만 health check를 통과한 local model이나 명시적인 budget이 있는 remote API로 넘긴다.
답 후보는 private evidence store에 모은다. independent verifier를 통과한 결과만 단일 submission broker가 제출한다. 공식 cutoff가 오면 broker를 닫고, 진행 중인 작업을 drain/cancel한 뒤 최종 CTF 결과와 local tracker를 대조한다.
- 01challenge ID를 키로 하는 canonical queuechallenge별 활성 lease
- 02검증된 artifact intake파일 형식, hash, provenance 기록
- 03결정적 local analysis제안된 처리 순서의 첫 단계
- 04health check를 통과한 model routinglocal model 또는 budget을 정한 remote API
- 05private evidence와 독립 검증제출 전 answer candidate를 확인
- 06단일 submission broker와 cutoff점수 대조 전에 제출을 닫음
아래 비교는 남아 있는 기록이 보여주는 범위와 다음 설계 제안을 분리한다.
V1 — 기록에서 확인된 범위
근거가 불완전하며, 처음부터 끝까지 검증된 pipeline은 아니다.
- challenge snapshotchallenge snapshot 110개
- local attachment20개 ID에 연결된 파일 21개; 실제 연결 관계는 확인되지 않음
- 상태 tracker110행; 제출 결과 107건 기록
- 기록된 결과correct 101건; incorrect 6건
- ingest와 assignment 방식; challenge별 owner; solver 연결 관계
- 제출 자동화와 retry; route telemetry; cutoff 후 결과 대조
trace에는 OMP/model의 병렬 활동이 남아 있다. challenge별 할당과 route 연결은 확인되지 않았다.
V2 — 다음 설계 제안
대회 당시 구현을 설명하는 것이 아니라 다음 버전을 위한 설계안이다.
- 01challenge source문제 설명과 artifact 참조
- 02ingest + artifact integrityhash, type, 불변 packet 기록
- 03canonical challenge queue + keyed owner leasechallenge마다 owner 하나; append-only state transition
- 04risk-tiered solver routing
- Local fast
- Local strong
- API escalation
- 05candidate + evidenceprivate 보관; payload는 vault에 저장
- 06independent verifierevidence와 형식 검증 gate
- 07submission broker요청을 하나로 모으고 cutoff에서 중지
- 08CTFd 응답 + 결과 대조HTTP status와 정답 판정은 다름
- append-only event ledger
- challenge별 owner lease
- 사람의 개입 기록
- route/token/cost telemetry
- global cutoff / close barrier
- 공식 결과 대조
오른쪽 항목은 모두 제안이며 대회 당시 기록으로 확인된 사실이 아니다.
돌아보면
이번에 얻은 결론은 “agent를 더 붙이면 더 많이 푼다”가 아니었다.
개별 worker가 어느 정도 일을 하기 시작하면 병목이 위로 올라간다. ownership, state, verification, observability, shutdown이 제대로 안 돼 있으면 worker를 하나 더 붙이는 게 속도를 높이기보다 시스템을 더 이해하기 어렵게 만들 수도 있다.
다음에 다시 한다면 worker 수부터 늘리지 않을 것 같다. 먼저 “지금 이 challenge의 owner가 누구고, 어떤 상태를 거쳤고, 왜 이 결과가 나왔는가”를 한 줄로 추적할 수 있게 만들겠다. 그다음에 parallelism을 늘리는 편이 훨씬 낫다.
기록과 범위
- Figure 1은 공식 최종 결과인 26위·5,701점을 보여준다.
- local tracker에는 challenge 110개와 제출 결과 107건(correct 101건, incorrect 6건, 결과 미기록 3건)이 남아 있다. correct 행의 nominal point 합은 5,900점이며 공식 5,701점과의 199점 차이는 확인되지 않았다.
- Figure 4는 대회 중 29위·4,401점 시점의 공개 crop이다. 같은 원본의 OMP 화면과 challenge별 이력은 공개하지 않았다. 약 13:53 JST의 302위·1점은 그보다 더 이른 상태다.
- 보조 timeline과 Figure 5의 V1은 남아 있는 기록을 바탕으로 재구성한 자료이고, V2는 제안이다.
- challenge별 model route와 사람의 개입 횟수는 불완전해서 정확한 자동화율은 제시하지 않는다.